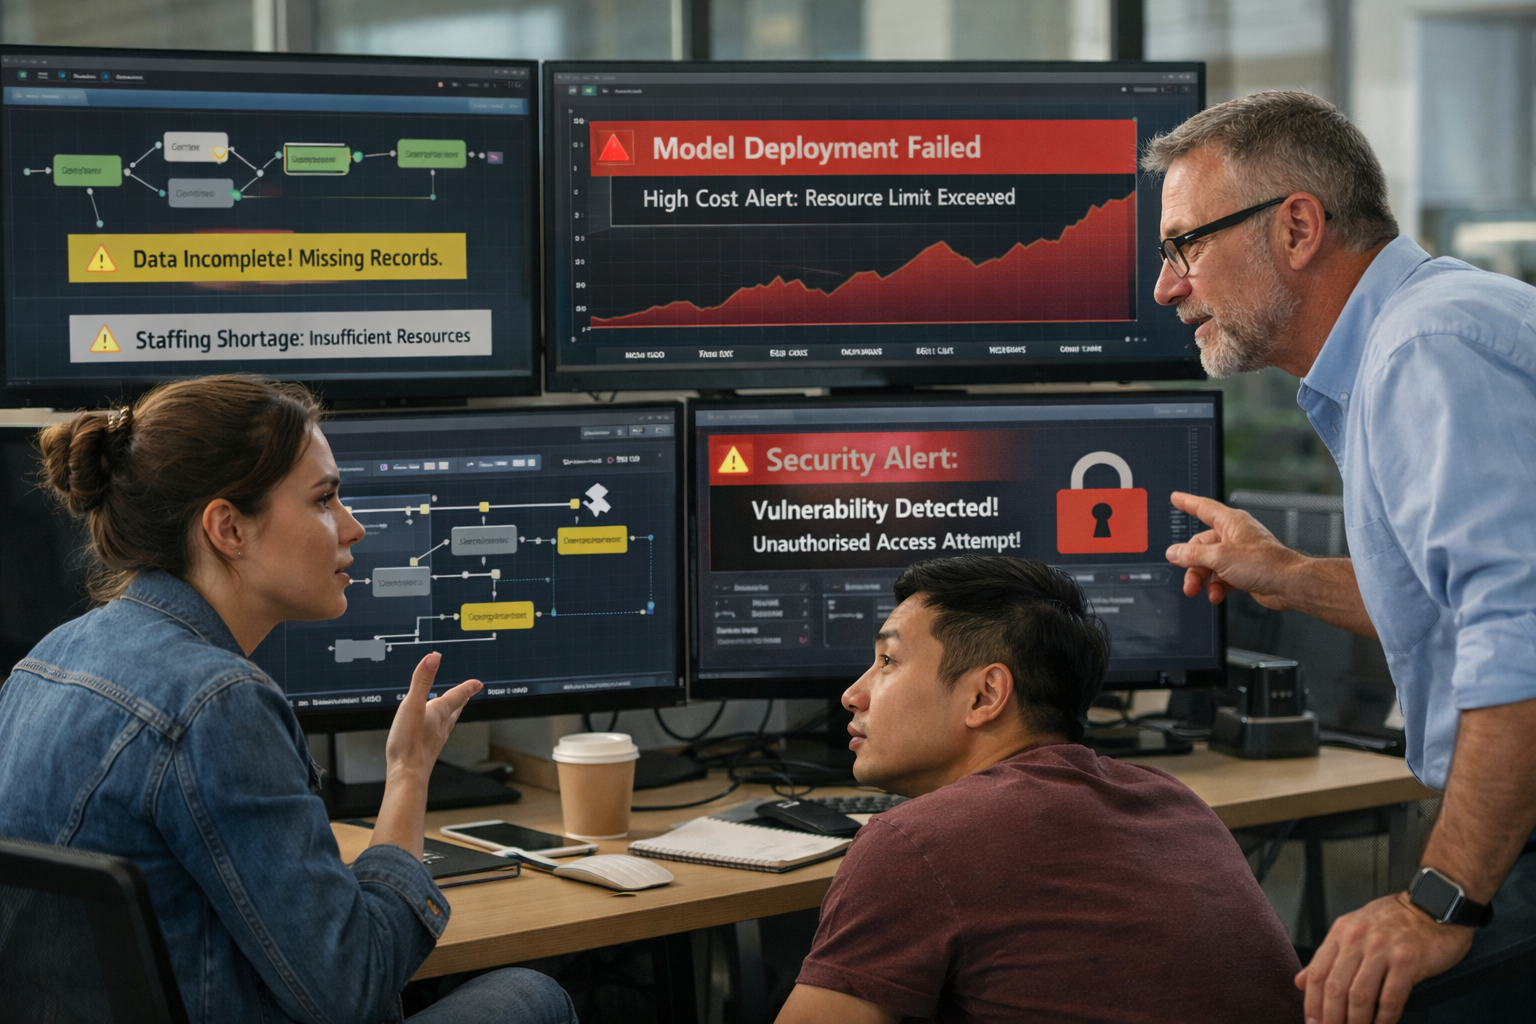
Firmy po celém světě zvyšují investice do umělé inteligence, samotný nákup technologií však úspěch nezaručuje. Při převodu experimentálních modelů do běžného provozu narážejí zejména na nedostatek odborníků, kvalitu dat, bezpečnost a schopnost systém dlouhodobě rozšiřovat.
Klíčovou roli v tomto procesu hraje MLOps, tedy soubor postupů pro automatizaci vývoje, nasazování a správy modelů strojového učení. Jde o obdobu přístupu DevOps ve vývoji softwaru, rozšířenou o práci s daty a modely. Zavedení MLOps vyžaduje změnu pracovních postupů, ale firmám může pomoci lépe řídit náklady, termíny i očekávanou návratnost projektů s AI.
První bariérou zůstává trh práce. Portál Glassdoor uvádí více než 30 tisíc pracovních nabídek souvisejících s datovou vědou a přes 15 tisíc pozic pro machine learning inženýry. Rostoucí poptávka po těchto profesích zdražuje nábor a zároveň zvyšuje riziko odchodů zkušených zaměstnanců. Výpadek lidí se specializací na data či modely pak může zpomalit celý životní cyklus projektu i spuštění nových iniciativ.
Podniky proto rozšiřují nábor mimo své bezprostřední okolí, využívají práci na dálku nebo budují vlastní zdroje talentů prostřednictvím stáží a absolventských programů. Jde však spíše o dlouhodobou cestu. V počáteční fázi mohou firmy využít také externí poradce, například při hledání vhodného využití AI, návrhu architektury MLOps nebo tvorbě prvního ověřovacího projektu.
Rozpočet i termíny určují data a připravenost firmy
Mnoho podniků se potýká už se samotným začátkem. Zásadní je vymezit obchodní problém, ověřit realističnost očekávání a zjistit, zda má firma pro zamýšlený model vhodná data. Teprve na tomto základě lze posoudit připravenost organizace, určit priority, sestavit rozpočet a stanovit proveditelný harmonogram.
Data přitom mohou projekt rozhodnout. V řadě společností historicky nevznikaly sběrné procesy s ohledem na budoucí využití v AI, takže záznamy bývají neúplné, nekonzistentní nebo uložené ve vzájemně nekompatibilních formátech. Modely strojového učení navíc obvykle vyžadují velké objemy informací z různých zdrojů. Náklady na jejich čištění, sjednocení a správu proto mohou významně ovlivnit ekonomiku celé iniciativy.
Pomoci může centralizované ukládání dat, průběžná kontrola jejich kvality a verzování datových sad, které umožní dohledat změny v podkladech pro model. Takové postupy omezují rozpory mezi daty a usnadňují přípravu před nasazením modelu do provozu.
Bezpečnost a škálování rozhodují o cestě do provozu
Další finanční i provozní riziko představuje bezpečnost. Modely často pracují s citlivými údaji a jejich datové kanály či koncové body mohou být při nedostatečném zabezpečení veřejně dostupné. Zpráva IBM o zavádění AI uvádí, že potíže se zajištěním bezpečnosti dat zmiňuje každá pátá firma. Bezpečnostní profesionálové tvořili 25 % respondentů.
Častým problémem jsou neaktualizované knihovny se známými zranitelnostmi, stejně jako nedostatečně chráněné datové pipeline a přístupové body modelů. Pro dlouhodobý provoz je proto nutné průběžně instalovat bezpečnostní opravy, mít jasná pravidla přístupů a oddělit citlivé projekty či týmy v rámci společného technického prostředí.
Podle McKinsey se organizace postupně posunuly od experimentování k začleňování AI do podnikových aplikací. Tento přechod zvyšuje nároky na infrastrukturu, automatizaci nasazování, sledování výkonu modelů i včasné upozorňování na problémy. Část firem proto volí otevřená řešení; mezi platformy určené pro širší správu MLOps patří například Charmed Kubeflow. Při škálování ale rozhoduje především to, zda firma dokáže propojit technologie s dostupnými lidmi, kvalitními daty a průběžně řízeným rozpočtem.